한국어 비꼼 탐지기
1 Overview
한국어 문장을 넣으면 비꼬는 말인지 아닌지를 판별하는 분류 모델을 만들고, 직접 써볼 수 있는 웹페이지 데모를 만들었습니다.
2 Context
우리는 종종 실제 의도와 반대되는 표현을 사용해 불만이나 못마땅함, 유머를 전합니다. 칭찬인지 핀잔인지 사람은 대충 알아듣지만 모델도 그럴까요? 이런 애매한 표현을 어디까지 구분할 수 있을지 궁금했습니다.
프로젝트를 시작할 당시 Kaggle에는 비꼼 탐지와 관련된 프로젝트가 500개 이상 있었지만, 대부분 영어를 대상으로 하고 있었고 한국어를 다룬 사례는 드물었습니다. 그래서 한국어 문장의 비꼼 여부를 분류하는 모델을 만들고, 누구나 문장을 입력해 결과를 확인할 수 있는 웹페이지까지 구현해보기로 했습니다.
3 Approach
데이터 특성 확인
GitHub에 공개된 트위터 기반 한국어 비꼼 데이터셋을 사용했습니다. 문장과 비꼼 여부가 짝지어진 데이터로, 학습용 8,999개와 테스트용 301개가 제공되어 있었습니다.
먼저 결측치 한 개를 제거하고 데이터를 살펴봤습니다. 두 데이터의 크기 차이가 커서 하나로 합친 뒤 3:1 비율로 다시 나눴고, 각 데이터에서 비꼼 문장과 비꼼이 아닌 문장의 비율이 같도록 맞췄습니다.
문장은 25자 안팎인 경우가 많았지만 평균 길이는 약 50자였습니다. 길이 분포가 학습 데이터와 평가 데이터에서 비슷한 것을 확인하고, 모델에 넣을 문장의 최대 길이도 50으로 정했습니다.
한국어 텍스트를 분류 모델이 처리할 수 있는 형태로 바꾸기
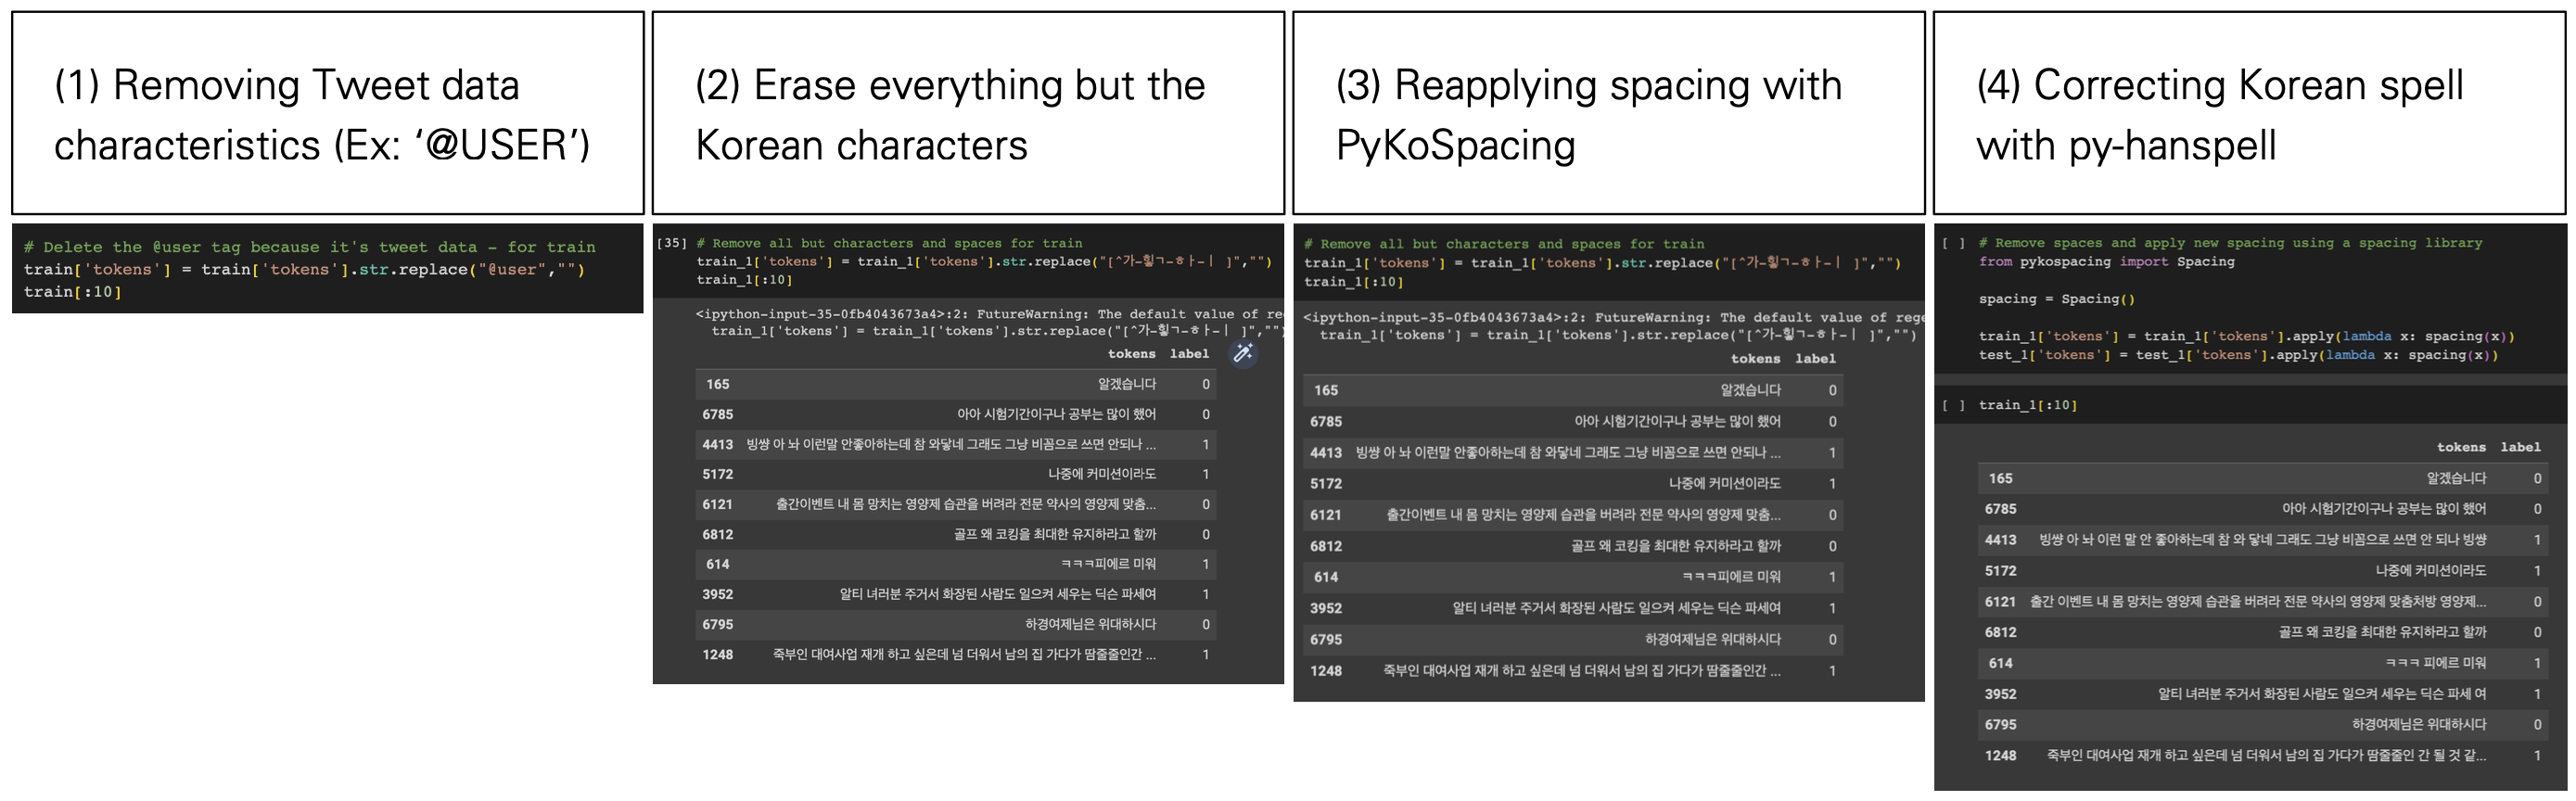
트윗 데이터의 특성과 한국어 문장의 특성을 고려해 말뭉치를 단계적으로 전처리했습니다.
- 트윗에 남아 있는
@USER표기를 제거했습니다. - 한글 이외의 문자를 제거했습니다.
- 띄어쓰기를 제거한 뒤 PyKoSpacing으로 띄어쓰기를 다시 적용했습니다.
- py-hanspell을 이용해 맞춤법을 보정했습니다.
- Okt 형태소 분석기로 문장을 형태소 단위로 나누었습니다.
한국어는 단어 하나가 여러 형태소로 이루어질 수 있어 형태소 분석이 필요했습니다. 여러 분석기를 살펴본 뒤, 새 문장에도 적용할 수 있고 속도와 성능이 적절한 Okt를 골랐습니다.
모델이 형태소를 읽을 수 있도록 각 형태소를 숫자로 바꿨습니다. 학습 데이터에서 확인된 어휘는 약 19,325개였습니다. 그중 한 번만 등장한 단어가 전체 어휘의 약 60.11%였지만, 전체 단어 등장 횟수에서는 약 12.38%를 차지했습니다. 드물게 쓰이는 단어도 비꼼을 알아채는 단서일 수 있다고 보고, 따로 제거하지 않았습니다.
데이터의 약 99.28%가 길이 50 이하였기 때문에 문장 길이는 최대 50으로 맞췄습니다. 50보다 짧은 문장에는 0을 채웠습니다.
전통적 분류 모델에서 문맥의 한계 확인
먼저 다섯 가지 분류 모델을 시험했습니다.
- Naive Bayes
- Support Vector Machine
- Logistic Regression
- Random Forest
- Decision Tree
Random Forest를 이용해 문장을 입력하면 비꼼 여부와 확률을 보여주는 기능도 만들었습니다. 결과는 확률에 따라 Likely Sarcastic, Possibly Sarcastic, Unclear, Unlikely Sarcastic 네 단계로 나눴습니다.
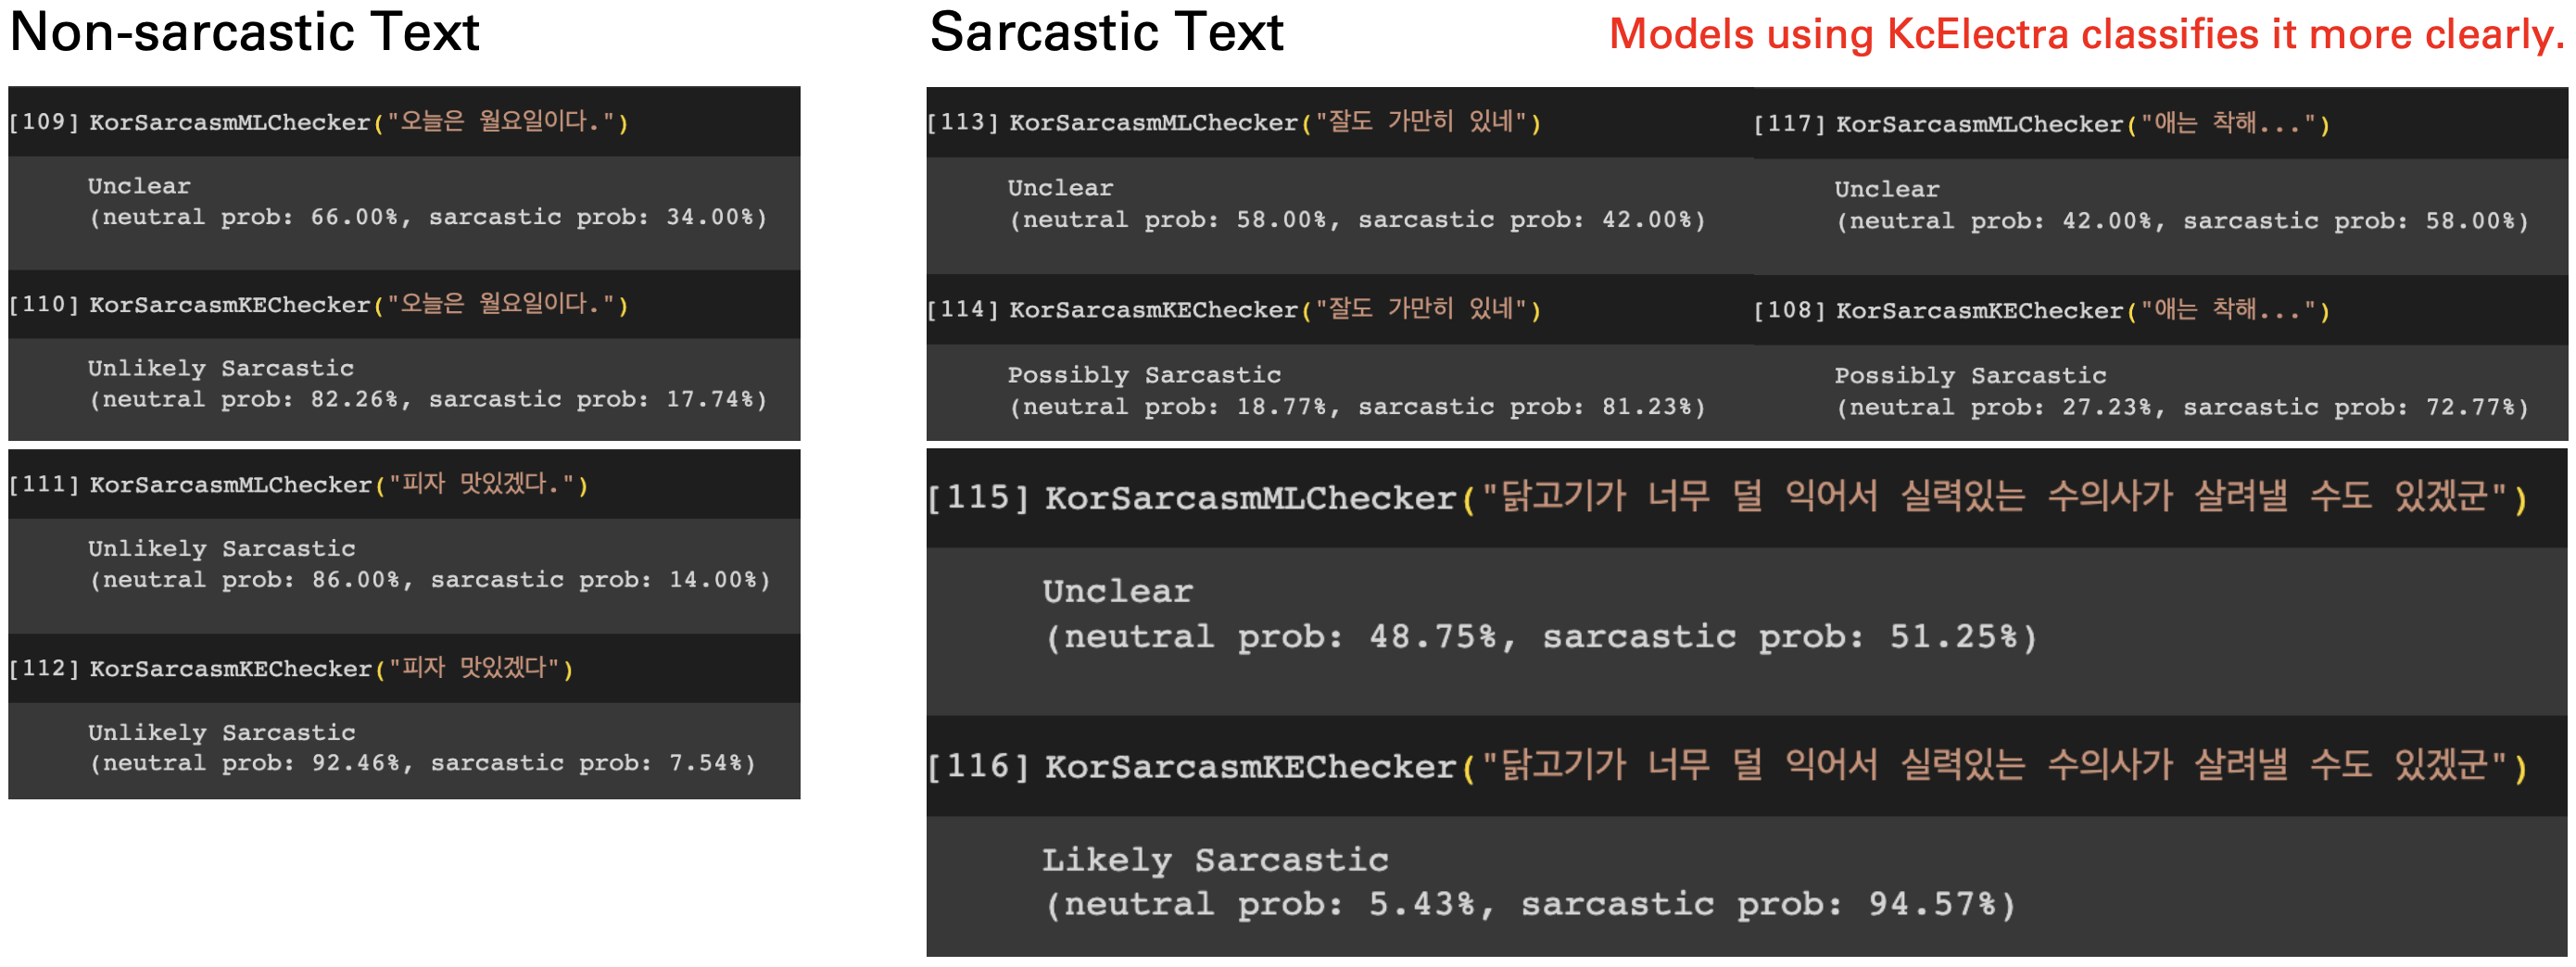
그런데 모델은 “오늘은 월요일이다”, “피자 맛있겠다”처럼 비꼼이 아닌 문장은 비교적 잘 구분하면서도, “잘도 가만히 있네” 같은 문장은 비꼼으로 잘 알아채지 못했습니다. 비꼼 확률이 낮게 나오거나, 비꼼과 비꼼이 아닌 문장의 확률이 비슷하게 나왔습니다.
KcELECTRA
접근을 바꾸어, 대규모 텍스트로 학습된 언어 모델을 가져와 한국어 비꼼 데이터에 맞게 파인튜닝시키기로 했습니다.
베이스 모델로 KcELECTRA를 선택했습니다. KcELECTRA는 네이버 뉴스 댓글과 대댓글을 포함한 약 8,900만 문장으로 학습된 한국어 ELECTRA 모델입니다. 사용자 생성 텍스트와 노이즈가 많은 텍스트를 다루도록 학습되었기 때문에 트위터처럼 표현이 자유롭고 잡음이 있는 텍스트를 다루는 데에도 적합하다고 판단했습니다.
데이터에 맞춰 미세조정한 뒤 정확도는 84%였습니다. 앞서 잘 알아채지 못했던 문장들을 다시 넣어보니, 비꼼 예시에서 비꼼 확률이 70% 이상으로 나타났습니다. 처음 사용한 모델보다 결과도 더 분명했습니다.
4 Outcome
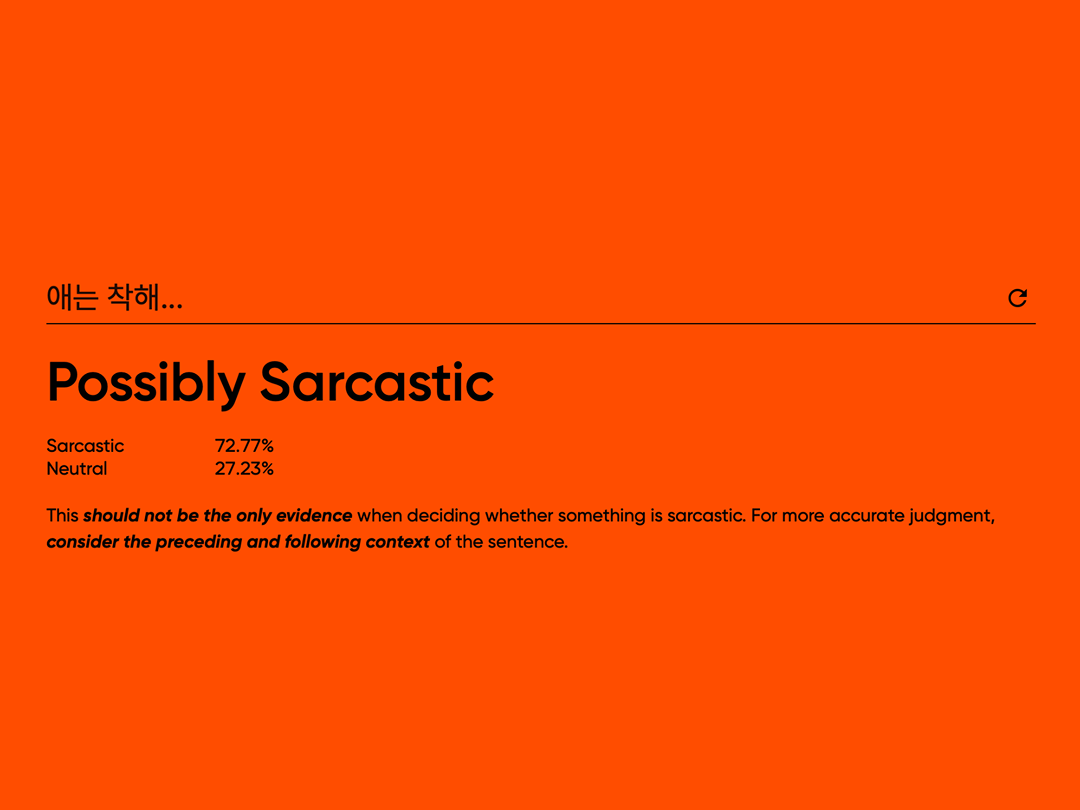
모델을 직접 써볼 수 있도록 입력 페이지와 결과 페이지를 만들었습니다. 문장을 입력하면 비꼼 여부와 비꼼 및 비꼼이 아닐 확률을 확인할 수 있습니다. 비꼼으로 분류된 결과는 주황색 배경으로 표시했고, 사용한 데이터셋과 모델 정확도를 페이지에서 볼 수 있게 했습니다.
5 Reflection
자연어 처리와 기계학습을 직접 적용해본 첫 프로젝트였습니다. 처음에는 낯선 개념이 많았지만, 필요한 모델을 찾아보고 목적에 맞게 활용하면서 새로운 문제를 위한 분류기를 만들 수 있었습니다.
모델을 고를 때는 정확도만 비교하는 것으로 충분하지 않았습니다. 모델이 어떤 방식으로 작동하는지, 지금 다루는 데이터와 문제에 잘 맞는지도 살펴야 했습니다. 모델의 판단을 사용자에게 어떻게 보여줄지도 함께 고민해볼 수 있었습니다.